jing-hy/picturereader
DSH plugin: pixel-to-text image reading for text-only models. image_scan/image_ocr/image_sample tools + image-reading skill (34-image trained methodology). Pure local, optional PaddleOCR.
Listed
14
Vision
Bundle verified
Preview
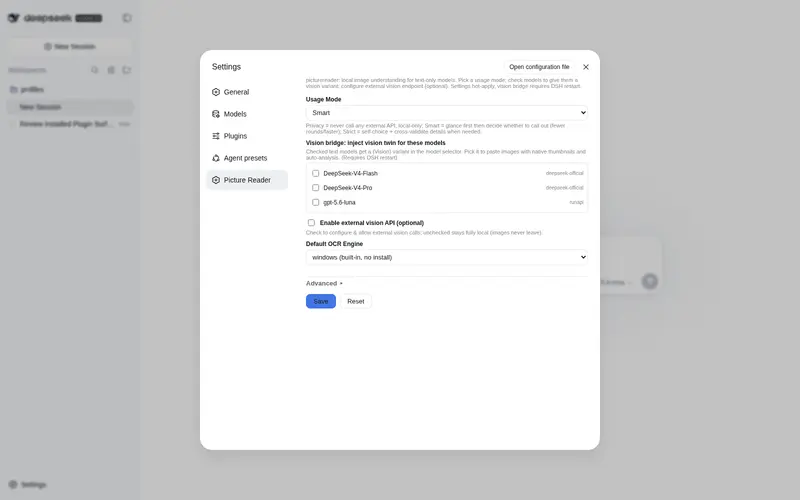
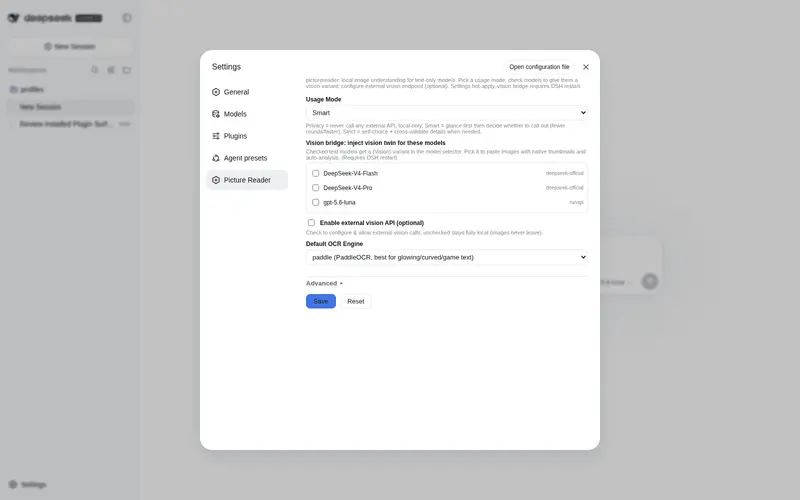
What it does
Image "reading" for text-only models: downscale + reduce color depth + structure/color fingerprints into text grids fed back to the conversation, letting the model zoom, sample and OCR autonomously like a multimodal model; fully local with zero external model dependency, ships an image-reading methodology skill and optional PaddleOCR.
Best for
- Users of text-only models who need local image inspection through textual structure, color, sampling, zoom, and OCR evidence.
- Privacy-sensitive or offline workflows that must keep image analysis local by using privacy mode.
- Teams that want optional external VLM assistance while retaining local pixel and OCR evidence for cross-checking.
- DSH users who need images and supported documents converted into a form a text-only model can investigate autonomously.
Not ideal for
- Workflows centered on WebP images unless files can first be converted to PNG or JPEG.
- Users who cannot restart DSH after enabling the visual twin or changing selected vision models.
- Profiles that must keep `dsh-file-drop` active, because its image injection can conflict with this plugin's automatic analysis.
- Uploads exceeding the host's attachment limit, which is about 5 MB per image by default even though the tool read limit is higher.
README
picturereader
v3.0.3 — 给纯文本模型(DeepSeek / text-only)的全能「看图 / 读文档」能力:粘贴即用、原生缩略图。 融合 视觉孪生 adapter(把任意文本模型原位包装成「支持图片」→ DSH 原生缩略图 + 图片块自动分析)、三模式路由、本地像素级工具链(scan / OCR×3 引擎 / crop / palette / compare / batch)、文档转图片(pdf / word / excel / ppt)与可选外部 VLM 桥。一个插件全包,无需另装。

定位
DeepSeek 等纯文本模型没有视觉编码器,无法直接看图片;DSH 原生缩略图也需要模型被声明为「支持图片」才会渲染。
⭐ 已支持外部视觉 API(OpenAI 兼容端点 / LM Studio / 云端 VLM),由 LLM 自行按需调用:配置好端点后,模型会在智能/严谨模式下自主判断”这张图值不值得外呼视觉模型”,需要时用
vision_analyze调外部 API 做语义理解,简单内容则本地像素/OCR 搞定——外部 API 是即插即用的增强能力,不是必须依赖。
picturereader 解决两件事:
- 把「看图/读文档」翻译成纯文本模型能理解的结构化证据(像素级 huel/结构/材质分析 + OCR 实读 + 可选 VLM 语义描述),并沉淀为读图方法论 skill。
-
通过「视觉孪生 adapter」让纯文本模型在 DSH 里获得原生缩略图体验:勾选模型即生成「(视觉)」变体,粘贴图片显示原生缩略图、图片块进会话、并被自动分析成文本路径 + 本地证据再交给模型——模型拿到的永远是纯文本,不会触发
UNSUPPORTED_CONTENT。
版本徽章与兼容性:已验证兼容 DeepSeek Harness EAC 4.2.0 与
@deepseek-ai/dsh-client-ui-workspacerc.7。
🚀 后续将作为 DeepSeek Harness EAC 的内置视觉插件:本插件计划替换内置的
dsh-tool-vision,随 DSH EAC 桌面版直接捆绑发布,开箱即用(见上游 PR)。作为独立包发布的目的,是让非 EAC / 旧版用户也能通过dsh plugin add picturereader或 Git/npm 安装获得同等「看图 / 读文档」能力。
功能总览
① 视觉孪生 adapter(原生缩略图 + 自动分析)
-
Proxy 原位包装:对被勾选的模型所属 provider,用
Proxy把其 adapter 包装成「孪生」并原位替换(registerTwinAdapters,卸载经ctx.effect还原),不重复注册。 -
listModels/resolveModel:对被勾选模型声明inputModalities: ['text','image']、名称加「(视觉)」后缀 → DSH 认为它支持图片 → 原生缩略图渲染、图片块进会话、粘贴准入全部解锁。 -
stream拦截:捕获请求里的imageblock → 导出到~/.dsh/picturereader-vision/images/→ 替换成文本路径 + 本地工具链引导 → 转发给原始 adapter。pi-ai 收到的是纯文本,不会报UNSUPPORTED_CONTENT;opencode-go等走@earendil-works/pi-ai的 provider 同样经此孪生获得原生缩略图能力。 - 隐私模式下分析只走本地工具,绝不外发。
② 智能路由(隐私 / 智能 / 严谨 三模式)
这是 picturereader 的”大脑”:统一在 routing.js + runtime.js 收敛「什么时候走外部 VLM、什么时候只用本地、要不要交叉验证」,供各工具 / 图片桥 / 视觉孪生 stream / vision_analyze 共享,保证整条图链都遵守同一套路由策略。
路由决策原理
每次看图,模型面对的问题其实是同一个:「这张图,值得花什么成本、用哪条路线读懂它?」picturereader 把答案预置成三种策略,模型据此自主决策,同时 host 侧做硬约束兜底:
图片进来 → 孪生 stream 拦截 / 工具被调用
        → 读入当前「模式」→ 得到该模式的路由策略
        → 模型 / 工具按策略选路线:
            本地像素分析(image_scan / image_sample)
            本地文字识别(image_ocr:windows / paddle / rapid)
            外部语义理解(vision_analyze include_vlm=true → VLM)
            交叉验证(多路证据对照)
核心决策函数 visionAnalyzeDefaults(mode) 定义各模式”默认的证据组合”:
| 模式 | 默认 include_scan | 默认 include_ocr | 默认 include_vlm | allow_low_info |
|---|---|---|---|---|
| 隐私(privacy) | ✅ | ✅ | ❌(硬禁) | ❌ |
| 智能(smart) | ✅ | ❌(按需) | ✅(值得才调) | ❌ |
| 严谨(strict) | ✅ | ✅ | ✅ | ❌ |
三种模式的路线策略
🕶 隐私模式(Privacy)——零外呼硬门禁
- 绝不调用任何外部视觉端点,即使你在设置卡配了 API。
- 约束是 host 侧强制:
runtime.js使isVlmConfigured()恒为false,vision_analyze强制include_vlm=false,视觉孪生stream的降级文本也明确”只用本地工具”。 - 模型只能用本地工具:
image_scan/image_ocr/image_sample/image_crop/image_palette/image_compare。图片字节不出本机。 - 适用:敏感图片(身份证、合同、私人截图)、离线、零外部流量审计场景。
⚡ 智能模式(Smart)——省轮数、省时间(默认)
- 目标:先把成本压到最低,复杂内容才值得外呼。
- 决策流程:先
image_scan快速看整体 → 自行判断:- 图片以文字为主 →
image_ocr读文字即可,不必调 VLM; - 普通图表 / 界面 / 简单内容 →
image_scan+image_sample自己看就能说清,不必调 VLM; - 仅当内容复杂、需语义理解(照片、抽象画面)且配置了端点时,才
vision_analyze(include_vlm=true)走外部 VLM。
- 图片以文字为主 →
- 视觉孪生死活都会先把图片导出成本地路径,模型可随时本地深挖,不会被困在”必须外呼”的死路。
🎯 严谨模式(Strict)——交叉验证、细看细节
- 目标:可靠性优先,不贪省。
- 决策:先
image_scan了解整体 → 必要时image_ocr读文字、image_sample细看细节 → 对关键判断做交叉验证(把像素证据、OCR 证据、(可选)VLM 语义描述相互对照,不轻信单一来源)。 - 允许使用外部 VLM(需配置),但强度更高、可追溯。
- 适用:需要高准确率与可复现结论的场景(审图、校对、数据分析)。
隐私硬门禁贯穿所有入口:无论走哪个工具/桥,
runtime.js的模式快照都会在调用点做校验,routePolicyText(mode)还会把当前策略注入给模型的提示里,双保险。
与视觉孪生 adapter 的协同
三模式不仅约束 vision_analyze,也约束视觉孪生 registerTwinAdapters 的 stream 拦截:图片块总是被无条件替换成文本(路径 + 本地证据引导,这是模型能读懂的前提),但是否/何时进一步外呼 VLM 由当前模式决定——隐私模式恒不透传图片、不发起外部调用;智能/严谨模式在需要且已配置时才走外部语义理解。因此”原生缩略图”与”隐私零外呼”可以同时成立,互不冲突。
③ 本地工具链(纯本地、纯 JS 像素级)
| 工具 | 作用 |
|---|---|
image_scan |
全局/区域扫描:颜色网格 + regions 色块 + shade diversity + texture + structure + hue families;支持 focus/region/px_per_cell 定向放大 |
image_ocr |
文字识别三引擎:windows(内置)/ paddle(选装,发光/弯曲/游戏字更强)/ rapid(选装,轻量快速),失败自动降级不崩溃 |
image_sample |
N×N 精确像素取样,判断材质/纹理 |
image_crop |
按 region 裁剪并导出 PNG |
image_palette |
颜色提取:主色列表(hex + 命名单 + 占比)+ 色相家族 |
image_compare |
两图/两区域像素对比:mean_diff / diff_ratio / diff_box / verdict,可选差异可视化预览 |
image_batch |
批量规模/上下文验证:批量扫描 + 类型判定 + 自动全量 OCR + 是否值得深入建议 |
vision_analyze |
统一入口:低信息拦截 + 可选像素扫描 / OCR / VLM,按模式路由,返回多路证据 |
④ 文档转图片 document_to_image
把 pdf / docx / doc / xlsx / xls / pptx / ppt 逐页转成 PNG(LiberOffice headless → PDF → PyMuPDF),供模型逐页 OCR / 扫描分析。纯本地、零网络;支持 dpi / max_pages / out_dir / 批量 file_paths。
⑤ 外部 VLM 桥(已支持,由 LLM 自行调用)
已支持外部视觉 API,且调用时机完全交给 LLM 自主判断:配置好 OpenAI 兼容端点后(LM Studio / llama-server / 云端网关 / GLM-4V-Flash 免费模型),模型在智能 / 严谨模式下会自行判断”这张图是否值得外呼视觉模型”——简单内容用本地像素/OCR 就够,复杂内容(照片、抽象画面、需语义理解)才通过 vision_analyze(include_vlm=true) 调 sendVisionRequest 以 data URI 送图给外部 VLM,取回语义描述。baseURL 自动补 /v1/chat/completions(无需手写完整路径)。
- LLM 自行调用 = 你不用手动切模型/手动发图,模型按模式策略在该外呼时自己调外部 API。
- 隐私模式仍为硬门禁:即使配置了外部 API 也绝不调用、绝不外发图片字节。
⑥ 设置卡片「图片阅读」
Web 设置页注册「图片阅读」卡片:使用模式、外部视觉 API、视觉桥模型多选、高级设置(详见「设置卡字段」)。改动写 ~/.dsh/settings.yaml 即时生效。
⑦ 粘贴即用 + 缩略图
开启视觉孪生并选择「(视觉)」模型变体后:粘贴/拖入图片 → 原生缩略图 → 图片块进会话 → 被孪生 stream 拦截 → 导出文本路径 + 本地证据 → 纯文本模型拿到结果,可继续用 image_scan / image_ocr 深挖。
与主流多模态插件的差异 / 优势
对比常见方案(dsh-tool-vision、dsh-image-paste、dsh-vision-bridge 等):
-
不绑定单一厂商:视觉孪生对任意 provider 生效(含
opencode-go/ xiaomi / qiu 等 pi-ai 系),不是只适配某一家 API。 - 全链路可离线:隐私模式零外呼;本地纯 JS 像素工具 + 3 引擎 OCR,不依赖云端。
- 工具链完整:裁剪 / 取色 / 对比 / 批量 / 文档转图,一个插件全覆盖。
-
原生缩略图:真正 DSH 原生图片块(
inputModalities声明),非文本路径模拟。 - 快:本地工具毫秒级;可控 VLM 调用(低信息拦截 + 智能模式”值得才调”)省轮数与耗时。
-
只写不读 key、隐私硬门禁:API Key 以
role:'secret'保存、只写不读不回显;隐私模式经runtime.js强制isVlmConfigured()=false。
| 能力 | picturereader | dsh-tool-vision | dsh-image-paste | dsh-vision-bridge |
|---|---|---|---|---|
| 原生缩略图(文本模型) | ✅ 视觉孪生 adapter | ❌ | ⚠️ 部分 | ❌ |
| 任意 provider(含 pi-ai 系) | ✅ | 绑定厂商 | — | — |
| 隐私模式硬门禁 | ✅ | — | — | ❌ |
| 本地像素工具链(scan/ocr/crop/palette/compare) | ✅ 全内置 | ⚠️ 基础 | ❌ | ❌ |
| 文档转图片(pdf/word/excel/ppt) | ✅ | ❌ | ❌ | ❌ |
| 批量/上下文验证 | ✅ | ❌ | ❌ | ❌ |
| 外部 VLM 桥(可选,OpenAI 兼容) | ✅ | ✅ | ❌ | ✅ |
| 全离线可用 | ✅ | ⚠️ | ✅ | ❌ |
快速上手
# 1. 安装插件
dsh plugin --profile web add picturereader        # npm 包;或从源码: dsh plugin --profile web add .
dsh plugin --profile headless add picturereader

# 2.(推荐)安装读图方法论 skill
copy skills\image-reading.md %USERPROFILE%\.dsh\skills\          # Windows
# cp skills/image-reading.md ~/.dsh/skills/                      # macOS / Linux

# 3.(可选)增强 OCR 引擎
node scripts/setup-ocr.mjs       # PaddleOCR(发光/弯曲/游戏字更强)
node scripts/setup-rapid.mjs     # RapidOCR(轻量快速)

# 4.(可选)文档转图片依赖(需已装 LibreOffice)
node scripts/setup-doc-venv.mjs  # 建 doc_venv 装 PyMuPDF
重启 DSH Desktop 后:模型工具列表出现全部工具,设置页出现「图片阅读」卡片。
启用视觉孪生(原生缩略图)
- 在设置页「图片阅读」勾选要作为视觉孪生的文本模型,保存后重启 DSH。
- 模型选择器中选择对应模型的「(视觉)」变体(如
deepseek-v4-flash (视觉))。 - 粘贴 / 拖入图片 → 原生缩略图 → 图片块自动分析为文本证据。
使用示例
用 image_scan 看一下 <路径> 这张图,细看感兴趣的部分
(复杂场景可接着用 vision_analyze;如有文字先 image_ocr;一批图用 image_batch;
  文档用 document_to_image 逐页转成图片再看)
三模式(使用模式)
在 Web 设置 →「图片阅读」卡片顶部选择,修改即时生效。
| 模式 | 是否调用外部视觉 API | 模型行为引导 | 适用场景 |
|---|---|---|---|
| 隐私模式 | 绝不调用(即使配置了 API) | 只走本地工具:image_scan / image_ocr / image_sample / image_crop / image_palette / image_compare | 敏感图片、离线、零外部流量 |
| 智能模式(默认) | 允许,但先本地看图再决定 | 先 image_scan 快速看,文字→OCR、简单图→本地、复杂图才 vision_analyze 外呼 |
日常,省轮数与耗时 |
| 严谨模式 | 允许 | 自行选择路线 + 多证据交叉验证 + 细看细节 | 需要高准确率与可追溯的场景 |
隐私模式约束是 host 侧硬门禁(
runtime.js):isVlmConfigured()在此模式下恒返回false,vision_analyze强制include_vlm=false,图片桥引导也明确「只用本地工具」。
设置卡字段(图片阅读)
-
使用模式:隐私 / 智能 / 严谨(
mode)。 -
启用外部视觉 API(选配):勾选后才显示并允许调用外部视觉端点;不勾选一律走本地,图片绝不外发(
vlm_enabled)。 - 勾选后显示:
-
视觉 API Base URL(
vlm_base,如https://api.openai.com/v1或http://127.0.0.1:1234;留空=禁用外部 VLM) -
视觉模型(
vlm_model) -
视觉 API Key(
vlm_key,password+secret:只写不读,留空保持当前,填写保存即覆盖、不回显) -
Key 环境变量(
vlm_key_env,apiKey 为空时回退读取) -
默认 OCR 引擎(
ocr_engine:windows / paddle / rapid)
-
视觉 API Base URL(
-
视觉桥模型多选(
vision_models):勾选即生成该模型的「(视觉)」变体;改动需重启 DSH 生效;已勾选模型会被兜底并入列表保持打钩,与孪生注入一致。 - 高级设置(折叠):
| 字段 | 默认 | 说明 |
|---|---|---|
vlm_timeout_ms |
300000 |
外部视觉请求超时(毫秒) |
vlm_max_tokens |
8192 |
外部视觉最大输出 Tokens |
bridge_export_dir |
空(系统临时目录) | 图片桥导出目录 |
max_image_bytes |
52428800 (50MB) |
单张图片读取大小上限(字节) |
scan_default_size |
32 |
image_scan 默认格子大小 |
scan_palette |
auto |
image_scan 默认色板(auto/full/basic/gray) |
scan_mode |
auto |
image_scan 默认模式(auto/ascii/color) |
ocr_language |
空 | OCR 默认语言(BCP-47,如 zh-Hans / en-US) |
multimodal_models |
空 | 多模态白名单(逗号分隔,这些模型直收图片不降级) |
request_guard |
true |
请求保护(llm/stream 最后防线降级 image block) |
batch_probe_first |
3 |
image_batch 探测前几张(判断是否文字密集) |
batch_ocr_limit_chars |
800 |
image_batch 每张 OCR 截断字符数 |
doc_dpi |
150 |
document_to_image 渲染 DPI |
doc_max_pages |
50 |
document_to_image 最大页数 |
debug |
false |
调试日志 |
环境变量
OCR(选装)
| 变量 | 默认值 | 作用 |
|---|---|---|
DSH_PADDLE_PYTHON |
C:\Users\Administrator\paddle_venv\Scripts\python.exe |
PaddleOCR 解释器路径 |
DSH_PADDLE_CACHE |
D:/coding/picturereader/.paddlex-cache |
PaddleX 模型缓存目录 |
DSH_RAPID_PYTHON |
C:\Users\Administrator\rapid_venv\Scripts\python.exe |
RapidOCR 解释器路径 |
文档转图片(选装)
| 变量 | 默认值 | 作用 |
|---|---|---|
DSH_SOFFICE |
C:/Program Files/LibreOffice/program/soffice.exe |
LibreOffice headless 可执行路径 |
DSH_DOC_PYTHON |
C:\Users\Administrator\doc_venv\Scripts\python.exe |
文档转换 venv 解释器路径(PyMuPDF) |
外部视觉 API / VLM(可选,也可在设置卡填)
| 变量 | 默认值 | 作用 |
|---|---|---|
SEE_API_KEY / GLM_API_KEY
|
空 | 视觉 API Key(设置卡 vlm_key 优先级更高) |
SEE_BASE |
智谱或设置卡 vlm_base
|
OpenAI 兼容视觉端点 |
SEE_MODEL |
glm-4v-flash 或设置卡 vlm_model
|
视觉模型名 |
SEE_SERVER_EXE / MODEL / MMPROJ |
空 | 本地 llama-server 自启路径(可选) |
SEE_SERVER_PORT / NGL / CTX |
8080 / 20 / 16384 |
本地服务器参数 |
设置卡
vlm_base / vlm_model / vlm_key优先于环境变量;隐私模式下即使配置也不调用。端点未写/v1时自动补/v1/chat/completions。
已知限制
-
DSH attachment 单图默认约 5MB:超大图片可能被宿主上传限制拦截;工具端的
max_image_bytes(默认 50MB)是读取上限。 - 原生缩略图需启用视觉孪生:文本模型默认不被 DSH 视为「支持图片」,需在设置卡勾选生成「(视觉)」变体并重启。
-
WebP 暂不支持:
image_scan/vision_analyze等对 WebP 报错,请先转成 PNG / JPEG。 -
视觉桥模型勾选需重启 DSH 生效(
vision_models的改动不会热加载)。 -
dsh-file-drop需停用:其「拖入图片即注入文本」与视觉孪生/图片桥的自动分析可能冲突(重复/竞争注入),建议在对应 profile 停用;原生缩略图 + 图片桥自动分析已覆盖该需求。 - 外部 VLM 依赖网络/端点:未配置端点或离线时自动跳过并给出提示;隐私模式恒不调用。
测试情况
v3.0.3 集成测试(2026-08-20)
132/132 单元测试通过 + 13/13 文档转换测试通过 + 全功能集成测试:
| 功能 | 状态 | 说明 |
|---|---|---|
| image_scan | ✅ | 4 种格式、region/focus/px_per_cell/palette/mode 全部正确 |
| image_ocr (windows) | ✅ | 中英文识别正常 |
| image_ocr (rapid) | ✅ | 带 confidence score |
| image_ocr (paddle) | ✅ | v3.0.3 修复字段名后正常 |
| image_sample | ✅ | 8×8 精确像素取样 |
| image_crop | ✅ | 裁剪导出 PNG |
| image_palette | ✅ | 主色提取 + hue families |
| image_compare | ✅ | 相同/不同图片判定正确 |
| image_batch | ✅ | v3.0.3 修复 cordis inject 后正常 |
| document_to_image | ✅ | PDF/DOCX/PPTX/XLSX 全部正常 |
| vision_analyze (本地) | ✅ | scan + OCR 证据返回正常 |
| 三模式路由 | ✅ | privacy/smart/strict 逻辑全部正确 |
| 视觉孪生 adapter | ✅ | 3 个 provider 激活 |
| 设置持久化 | ✅ | vision_models / ocr_engine / mode 全部保留 |
v3.0.3 修复
-
视觉桥模型列表持久化修复:修复了设置页「视觉桥模型」勾选后重新打开设置丢失勾选状态的问题。根因是
settings/document-updated事件触发scope.load()覆盖本地修改,改为通过lastSavedRef跟踪保存值,跳过同步覆盖。 -
OCR 引擎/模式设置持久化修复:修复了
ocr_engine和mode等 select 字段修改后重新打开设置恢复默认的问题。根因是onSave函数未正确处理 select 类型字段的默认值回退。 -
cordis 4 兼容性修复:修复了
image-batch.js和doc-tools.js中访问未声明ctx属性导致的报错。 -
PaddleOCR 字段名修复:
w/h字段改为width/height以匹配 schema。 -
本地 VLM 端点检测修复:
isManagedEndpoint扩展为识别所有127.0.0.1/localhost地址,不再要求 API key。
开发 / 仓库布局
# DSH 版(本仓库 main,代码在 dsh/)
npm install
npm test                       # node:test
node scripts/setup-ocr.mjs     # 可选
node scripts/setup-rapid.mjs   # 可选
node scripts/setup-doc-venv.mjs# 可选(文档转换)
node scripts/preview.mjs       # 生成 fixtures 并预览渲染
-
热插拔:业务逻辑集中在
src/core.js单文件,工具每次执行按 mtime 动态加载;工具定义(schema/描述)与设置卡改动需重启桌面端。 -
ZCode 版:位于本仓库 zcode 分支(源码在
zcode/),经 MCP server 暴露工具,安装npm install picturereader-zcode。两版共用src/core.js与读图方法论 skill。
License
MIT
Frequently Asked QuestionsFAQ
Use the verified command dsh plugin --profile default add github:jing-hy/picturereader in a DSH-enabled shell. The command resolves the public package metadata and keeps the plugin attached to the catalog identity shown on this page.
Compatibility follows the bundle and profile status shown above. If a profile is not detected, keep the plugin disabled there and check the repository documentation before enabling it in production.
The GitHub link and activity metadata are the source of truth for releases and maintenance. Revisit this page after a new release to confirm the catalog has observed the latest version.